Oracle SQL Developer를 활용한 DB 인덱스 실행경로 분석
Oracle SQL Developer를 활용한 DB 인덱스 실행경로 분석 — #OracleSQLDeveloper #DB인덱스 #개발자의도구들 #인덱스실행경로 #oraclesqldeveloper실행경로 컴...
#OracleSQLDeveloper #DB인덱스 #개발자의도구들 #인덱스실행경로 #oraclesqldeveloper실행경로
컴퓨터공학과 학사과정 중 공부한 내용을 정리하였습니다.
\* 본글은 PC버전에 최적화 되어있습니다.
INDEX
INDEX에 대해 알면 알수록 어려운 개념이 많은데, 오늘은 그냥 INDEX에 대한 간단한 설명과 SQL 위주로 설명을 해보겠습니다.
INDEX
여기에도 INDEX가..?
- WHY
- DEF
- what & why
- How does it work?
- index scan
- FULL table scan
- How to use(code)
- WORK LOAD
- META DATA
DEF
simple view and complex view
| ✏️ What & WHY |
|---|
DB의 인덱스는 SQL 처리 속도 향상을 위해 칼럼에 대해 생성되는 객체로 정의됩니다. 특점 칼럼을 index로 정의하게 되면 DB 실제 내부에서는 해당 객체가 생성되고, B+-Tree 형태로 정렬됩니다.
특히나 where절에 자주 사용되거나, join에 자주 사용되는 column을 index로 지정해서 사용하면 검색속도가 향상됩니다. 하지만, 대용량의 데이터를 불러올때는 오히려 속도가 느려지는 경우가 있기 때문에 전체 데이터 10~15%에서만 사용하도록 권장하고 있습니다.
How does it works?
| 🔍 Index Scan |
|---|
앞서서 index의 경우 B+Tree 형태로 coloum의 인스턴스들을 가르키는 주소가 저장되어있는데, 이 주소값을 참고하여 해당 인스턴스로 빠르게 접근이 가능합니다.
이렇게 테이블을 하나 하나 뒤지는게 아니라 주소값을 참고하여 해당 인스턴스로 접근하여 데이터를 찾기 때문에 소량의 데이터의 경우 빠른 속도로 조회가 가능합니다.
반면 대용량 데이터를 조회하는 경우, I/O가 단독으로 일어나기 때문에 디스크 헤드가 매우 비효율적이게 이동할 수 있습니다. 이에 따라 대용량 데이터의 경우 사용하지 않는 것이 좋습니다.
| 🔍 FULL Table Scan |
|---|
기본적으로 Index가 설정되어있지 않는 경우 전체 테이블을 처음부터 끝까지 scan합니다. 이렇게 되면 소령의 데이터를 찾기 위해 전체를 봐야하기 때문에 오버헤드가 발생합니다.
하지만, 대량의 데이터의 경우, I/O 처리가 연속적으로 이루어지기 때문에 헤드의 이동이 오히려 줄어들어 Index Scan보다 빠르게 스캔이 가능합니다.
How to use
본격적으로 Index를 사용해 봅시다.
| ⌨️ Create |
|---|
                                    CREATE INDEX idx_stud_name
ON student(name);
해당 index는 student의 name col에 대한 index를 생성한 것 입니다.
| ⌨️ more than two |
|---|
                                    CREATE INDEX idx_stud_name_birthdate
ON student(name ASC, birthdate DESC)
이렇게 name과 birthdate 두 칼럼에 대한 인덱스 역시 생성이 가능합니다. 이 경우, name에 대해서는 오름차순을, birthdate에 대해서는 내림차순을 적용합니다. 기본적으로 asc로 정렬됩니다.
| ⌨️ unique |
|---|
기본적으로 index를 생성하면, 해당 value에 대한 여러 인스턴스 주소값을 가지고 있습니다만, unique index의 경우 단 하나의 instance만을 가르키게 됩니다. unique key를 떠올리면 이해하기 쉽습니다.
                                    CREATE UNIQUE INDEX idx_uniq_stud_name
ON STUDENT(name);
| ⌨️ DROP |
|---|
Index를 제거하기 위해서는 DROP을 사용합니다.
DROP INDEX idx_stud_name
WORK LOAD
어떤 SQL이든 짜서 DB에 전달하면, DB는 실행 경로를 최적화하여 데이터를 조회합니다. 위에서 만든 INDEX를 통해 조회하는 경우와, INDEX가 없는 경우를 나눠서 직접 분석해 보았습니다.
                                    CREATE UNIQUE INDEX idx_uniq_stud_name
ON STUDENT(name);
현재 학생테이블의 name col에 대한 index가 생성되어있습니다. 이를 아래와 같은 쿼리로 조회해보겠습니다.
                                    select *
from student
where name = '홍길동';
해당 쿼리의 실행분석 (F10키 혹은 이미지 참고)
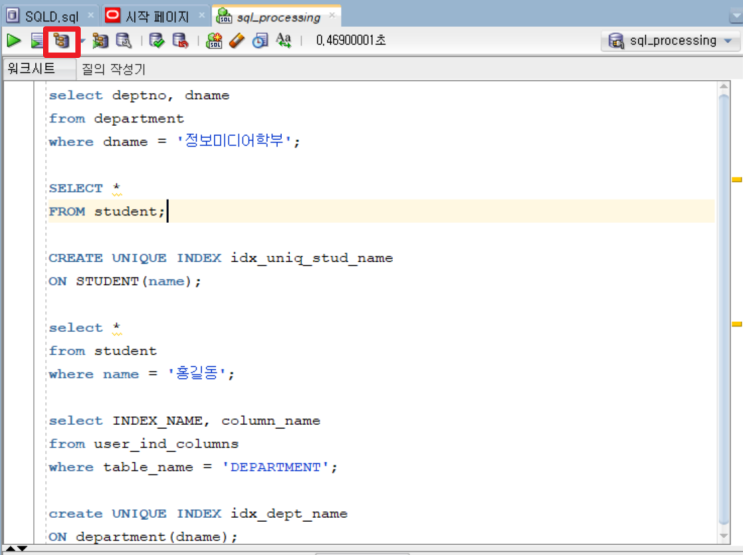
아래와 같이 실행계획이 나오는 것을 볼 수 있습니다.
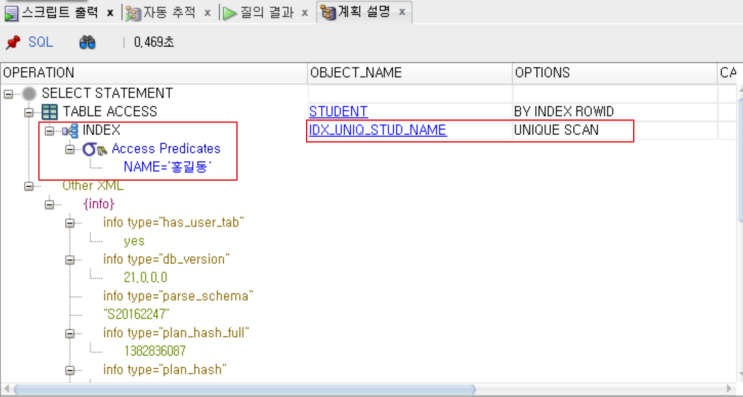
name을 index로 등록해둔 상태이기 때문에 해당 index를 확인할 수 잇으며, UNIQUE SCAN으로 적용된 것을 볼 수 있습니다.
| 🔍 FULL Table Scan |
|---|
이번에는 index로 등록하지 않은 칼럼으로 조회하면 어떤지 분석해 보겠습니다.
                                    SELECT *
FROM student
where height = 178; -- index로 등록하지 않은 height column
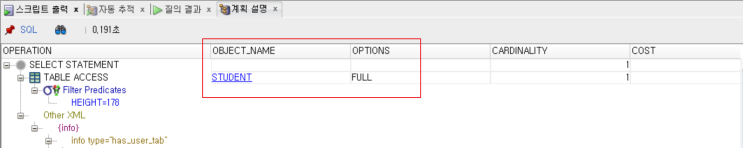
실행분석을 해보면 FULL SCAN이 이루어진 것을 볼 수 있습니다.
Metadata
인덱스에 대한 메타 데이터는 어디서 확인이 가능할까요?
두가지 경로를 통해서 확인이 가능한데, 우선 기본적으로 USER\_IDEXES 테이블을 사용할 수 있습니다.
                                    SELECT *
FROM user_indexes
where table_name = 'STUDENT';
주의할 점은 대소문자 구분을 해야하기 때문에 student로 조회하는 것과 STUDENT로 조회하는 것은 다릅니다.
다양한 column 들을 볼 수 있습니다. (인덱스 이름, 유일성 여부)
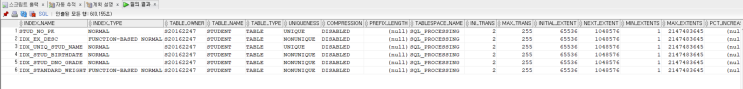
인덱스 이름과, 칼럼 위주의 정보는 아래와 같이 조회가 가능합니다. (위와는 다른 정보 출력)
                                    select *
from user_ind_columns;
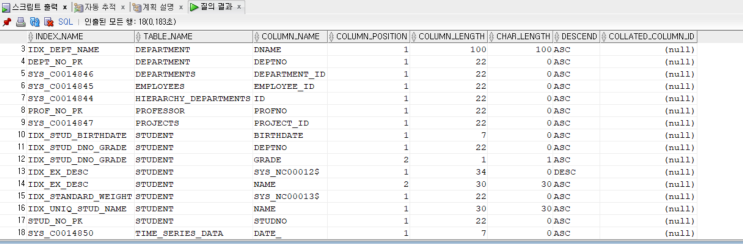
index와 관련된 column에 대한 정보를 담당하는 테이블입니다.