Langchain을 활용한 AI Agnet 개발 (LangSmith, 평가지표)
Langchain을 활용한 AI Agnet 개발 (LangSmith, 평가지표) — #AIagent #Langchain #aIagent개발 #AIAgent평가지표 #LangSmith *12.01일 진행한 내용입니다 아...
#RAG#Naver Blog
#AIagent #Langchain #aIagent개발 #AIAgent평가지표 #LangSmith
\*12.01일 진행한 내용입니다
아키텍처
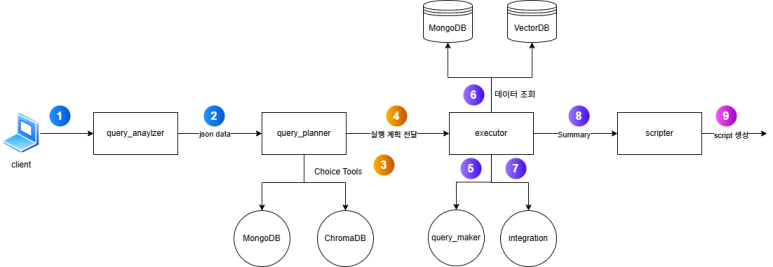
- 사용자가 쿼리합니다.
- ex) "10월 중순의 비트코인 가격 동향 및 주요 이슈 분석"
QueryAnalyzer
- : 사용자의 쿼리를 정규화 합니다.
QueryPlanner
- 정규화된 데이터를 바탕으로 사용할 Tools를 선택합니다.
- 실제 plan을 작성하여 executor로 전달합니다.
Executor
- plan을 분석하여 임베딩 검색용 쿼리를 생성합니다.
- 실제 데이터를 조회합니다.
- integration tool을 사용하여 데이터를 요약합니다.(프롬프트 대체)
- 요약된 결과를 전달합니다.
Scripter
- 요약된 결과로 부터 하나의 스크립트를 완성합니다.
LangSmith를 통한 분석
LangSmith는 각 Agent가 어떤 결과를 주고 받았는지 추적가능한 편리한 도구입니다.
Ai Agnet에서는 다음을 파악하는데 용이합니다.
- 어떤 tools를 사용했는가?
- 사용된 토큰량은 얼마인가?
- 각 단계별 in/out 결과는 무엇인가?
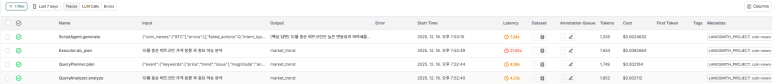
전체 토큰 사용량 및 비용을 한번에 추적할 수 있어 편하다고 생각했습니다.
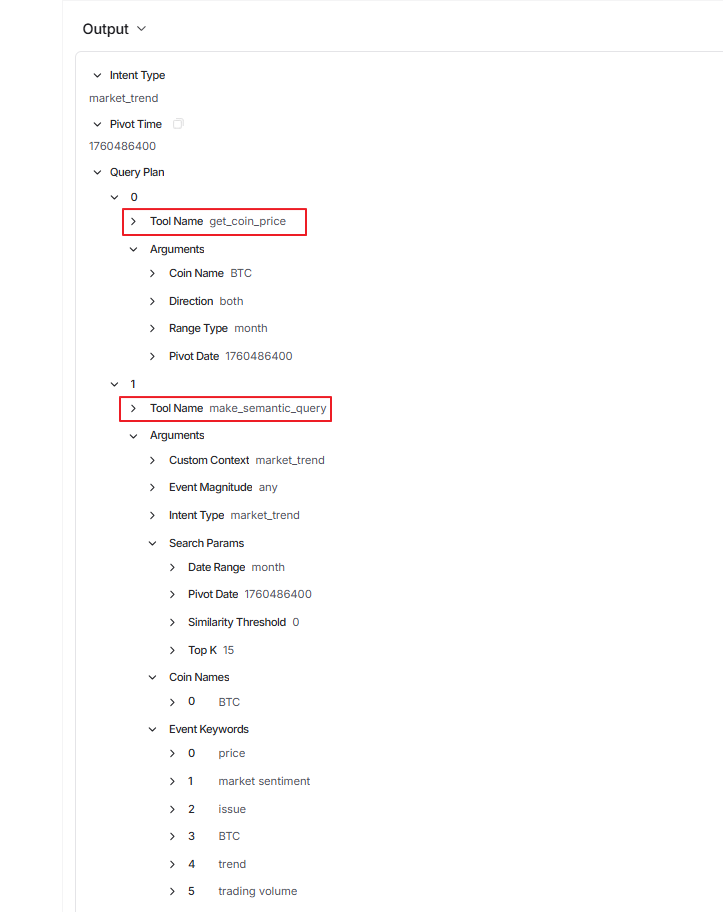
각 단계별로 클릭해서 분석해보면 output 결과를 확인할 수 있습니다.
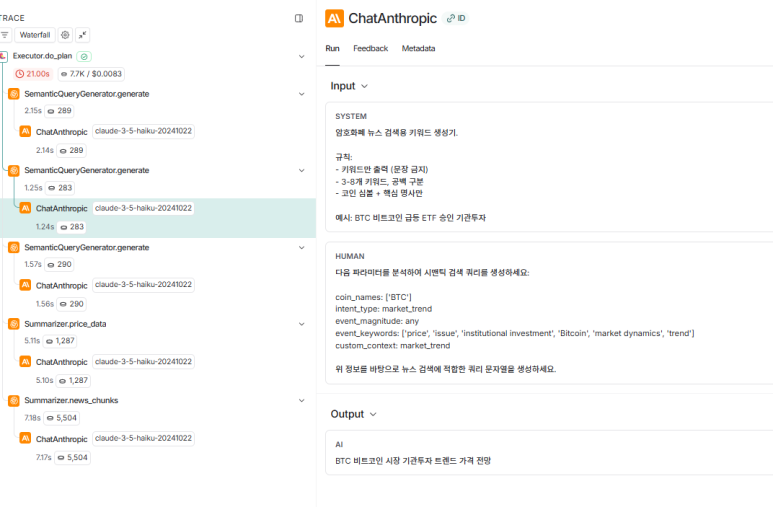
시스템 프롬프트, 유저 프롬프트, 아웃풋 결과를 한번에 확인할 수 있어 편리합니다.
평가지표
Agent를 평가할때는 다음과 같은 지표들을 참고합니다.
- 정확성 (Accuracy/Correctness)
Answer Correctness: 답변의 사실적 정확성
Factual Correctness: 생성된 내용의 사실 여부
Task Completion: 에이전트 작업 완료 성공률
Tool Correcteness: 도구 호출의 정확성 (올바른 도구 / 파라미터 선택)
- 신뢰성(Faithfulness / Groundedness)
Faithfulness: 응답이 제공된 컨텍스트에만 기반하는지 판단합니다 .
- Hallucination이 있는지 없는지?
Groundedness: 응답의 모든 주장이 컨텍스트로 뒷받침되는지 판단합니다.
- 출처 정보가 있는가?