어셈블리어 기초 다지기
어셈블리어 기초 다지기 — #정보처리기사 #개발자의도구들 #어셈블리어 #어셈블리어기초 컴퓨터공학과 학사과정 중 공부한 내용을 정...
#정보처리기사 #개발자의도구들 #어셈블리어 #어셈블리어기초
컴퓨터공학과 학사과정 중 공부한 내용을 정리하였습니다.
\* 본글은 PC버전에 최적화 되어있습니다.
C, assembly, machine code
view
Architecture: 프로세서 디자인의 한 종류이다. 어셈블리어나, 기계어를 쓰고 이해하는 방법을 설계
Microarchitecture: 주어진 아키텍처를 실제 하드웨어로 구현하는 구체적인 방법을 설명한다. 예를 들어, 데이터가 어떻게 이동하는지, 캐시 구조를 어떻게 짤 것인지 등
Machine Code: 바이트 단위로 기록된 이진 수 표현
Assembly Code: machine Code를 텍스트로 기록하여 사람이 알아볼 수 있도록 한 것
CPU와 메모리
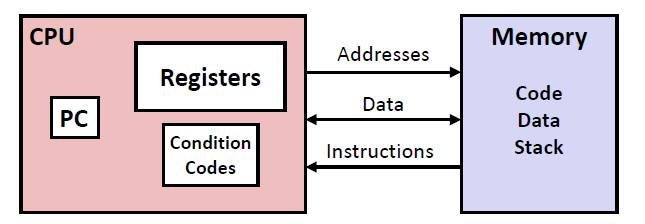
PC: 다음 명령어 주소가 저장되어 있는 레지스터입니다.
Register: 프로그램 데이터를 저장하는 작은 공간
Condition Codes: 상태정보나, 산술, 논리 연산을 관리.
메모리: 바이트 주소로 정렬된 배열 형태, 코드나 사용자 데이터를 저장한다..
Turning C into Object Code
우리가 작성한 C를 Object Code로 어떻게 변환할 수 있을까요?
| 💡Object Code란? 주로 기계어로 구성되어 있으나, 어셈블리어도 포함될 수 있습니다. 여기서는 이해하기 쉽게 기계어로 생각하시면 됩니다. |
|---|
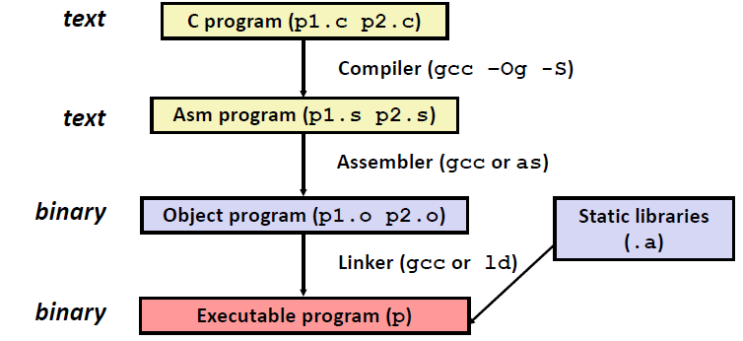
우리가 작성항 C언어 파일을 컴파일러를 통해 어셈블리 소스 파일로 만듭니다. 이때 파일 확장자로 .s가 사용됩니다. 이후 어셈블러는 Object Code로 코드를 변경합니다. 확장자는 .o가 됩니다. (기계어 수준)
마지막으로 Linker를 통해 import로 구현된 라이브러리를 불러와 최종적으로 프로그램을 실행 파일을 완성합니다.
\* .o파일을 .s변환하는 과정을 Disassembled라고 부르며 명령어 objdump -d sum를 사용합니다. 이는 Obejct 코드를 분석하는데 용이합니다.
어셈블리의 데이터 유형
정수
C에서는 Integer를 4바이트로 다루는데요. 어셈블리 언어는 다양한 크기의 정수 데이터를 다룹니다. 1바이트, 2바이트(word), 4바이트(double word), 그리고 8바이트(quadword)로 사용됩니다.
수치연산이나 메모리 주소 지정에도 사용됩니다. 이 크기에 따라 어셈블리어 표기법이 달라지니 기억해둘 필요가 있겠습니다. (아래 정리 해두었습니다.)
부동 소수점
부동 소수점은 일반적으로 4바이트(Single precision), 8바이트(Double precision), 10바이트(확장 정밀도) 의 크기를 가집니다.
코드
어셈블리 언어의 코드는 명령어들의 바이트 시퀀스로 구성됩니다. 이 명령어들은 CPU가 수행할 특정 작업들을 인코딩합니다.
집합 유형의 부재
어셈블리 언어는 배열이나 구조체 같은 집합 유형을 직접적으로 지원하지 않습니다. 대신, 메모리에 연속적으로 할당된 바이트로 이러현 유형을 구현합니다.
어셈블리 언어의 연산 및 데이터 전송
산술연산
레지스터나 메모리에 저장덴 데이터에 대한 산술 연산을 수행합니다.
데이터 전송
메모리와 레지스터간에 데이터를 전송합니다.
로드: 메모리에서 데이터를 레지스터로 들고오는 개념
스토아: 레지스터에서 메모리로 데이터를 보내어 메모리에 저장하는 개념
제어전송
조건부 분기에 대한 제어 전송
무조건적 점프: 특정 위지로의 점프 명령을 수행합니다.
조건부 분기: 특정 조건을 만족하면 수행되는 점프입니다.
어셈블리어에서의 레지스터
레지스터 표기법
우선 기본적으로 레지스터 종류를 표기하는 명령어를 익혀두는 것이 좋습니다. 아래 명령어는 기본 레지스터 형태로 16비트 레지스터를 의미합니다.
% ax : accumulate Register
레지스터에서 Acculmulator로 불리는 "누산기" 입니다. 주로 산술연산에 사용됩니다. 산술연산에서 사용할때, ax에 저장된 값을 불러들여와 계산합니다.
% cx : counter Register
반복 연산에서 카운터로 사용됩니다. 반복문의 i에 해당하는 부분이 사용될 수 있습니다..
% dx : data Register
입출력 연산에 사용되며, 일부 산술 연산에서 추가 데이터를 보관하는데 사용됩니다.
\* 산술연산에도 사용되긴 하는데, DX:AX쌍을 묶어서 사용합니다. 이때 AX레지스터는 나눠지는 수(분자)의 하위 16비트를 보관하고, DX레지스터는 분모의 16비트(상위)를 보관합니다.
| mov eax, 0x12345678 ; EAX에 하위 32비트 값 저장 mov edx, 0x00000001 ; EDX에 상위 32비트 값 저장(0x0000000112345678을 형성) mov ecx, 0x10 ; ECX에 제수 저장 div ecx ; ECX로 EDX:EAX를 나눔 ; 결과로 EAX에는 몫, EDX에는 나머지 저장 |
|---|
% bx : base
메모리 주소 지정에 사용됩니다. 메모리 주소의 기준점(베이스)으로 사용되어 데이터 위치 참조에 도움을 줍니다.
% si : source index
메모리에서 데이터를 읽어오는 데 사용되는 소스 인덱스 입니다. 주로 문자열과 배열 데이터를 처리할 때 소스 데이터의 주소를 지정하는데 사용됩니다.
% di : destination index
메모리에 데이터를 쓰는 데 사용되는 목적지 인덱스 입니다. 주로 문자열과 배열 데이터를 처리할 때 대상 데이터의 주소를 지정하는데 사용됩니다.
\* si, di의 이해
| mov esi, \[src\] ; src 배열의 주소를 SI 레지스터에 로드 mov edi, \[dest\] ; dest 배열의 주소를 DI 레지스터에 로드 mov ecx, n ; n 값을 카운터 레지스터 ECX에 로드 rep movsb ; ECX만큼 바이트를 SI에서 DI로 복사 |
|---|
% sp : stack pointer
현재 스택의 최상단을 가리키는 포인터로 사용됩니다. 함수 호출, 지역 변수 저장, 복귀 주소 보관 등 스택을 관리하는데 필수적인 레지스터입니다.
% bp : base pointer
함수의 스택 프레임을 구성하는데 사용되고, 함수 내 지역 변수와 매개변수에 접근하는데 사용됩니다.
확장된 레지스터 표기법
더큰 bit레지스터
32비트 레지스터에는 기본 명령어 앞에 "E"가 붙고, 64비트 레지스터에는 기본명령어 앞에 "R"이 붙습니다. 이는 레지스터가 저장할 수 있는 데이터 크기를 의미합니다.
기존 %AX, %BX연산 등의 앞에 붙여서 사용하는데, 이는 해당 레지스터가 몇 비트를 최대 저장할 수 있는지 직관적으로 파악하는데 도움을 줍니다.
%EAX : 32비트 레지스터를 사용한다
%RBX: 64비트 레지스터를 사용한다.
\* 8bit의 경우 16비트의 상, 하위로 구분된다.
%al : 8비트 레지스터를 사용, ah: 8비트 레지스터 -> %ax 내부에 포함되어 있다. l = low, h = high
%SI (16bit) = %SIH + %SIL (상위 8비트 + 하위 8비트)
%dI (16bit) = %DIH + %DIL (상위 8비트 + 하위 8비트)
상위 비트 레지스터는 하위 비트 레지스터를 보통 포함한다.
레지스터의 구성
레지스터는 1바이트, 2바이트, 4바이트, 8바이트로 확장되는데, 확장될때마다, 이전 레지스터가 큰 레지스터의 세그먼트로 사용됩니다.
예를들어 %AX는 %AH와 %AL 각각 8비트 레지스터로 상위 비트와 하위비트로 구분되어 있습니다. %AX의 상위 버전인 %EAX는 하위 16비트를 %AX로 구성하고, %RAX역시 하위 32비트를 %EAX로 처리합니다.
이는 하위 레지스터에 해당하는 값을 변경하여도, 상위 레지스터에는 하위 비트만 변경될뿐, 상위 비트는 변경되지 않습니다. 이해를 위해 아래 코드를 보겠습니다.
| mov eax, 0xFFFFFFFF : EAX를 최대 32비트로 설정 ; RAX는 0x00000000FFFFFFFF |
|---|
eax는 RAX의 하위 32비트를 구성하고 있기 때문에, RAX의 하위 비트만 업데이트 됩니다. 하지만, 상위비트를 직접업데이트하면 어떻게 될까요?
| mov rax, 0x123456789ABCDEF0 : rax 전체를 업데이트 ; RAX는 0x123456789ABCDEF0 // 전체 값이 업데이트 된다. |
|---|
\* ax를 제외한 eax, rax는 상위 비트에 대한 명칭을 따로 두지 않습니다. 이 부분은 각각 32비트, 64비트 연산에서 사용됩니다.
Moving Data
레지스터가 가장 많이 하는 행동은 바로 데이터를 옮기는 것 입니다. 데이터를 옮기려면 출발 레지스터에서 목적 레지스터로 데이터가 이동되어야 겠죠?
어셈블리어에서는 이런 데이터의 Move를 아래 명령어로 표기합니다.(x86-64 아키텍쳐 기준)
| movq Source, Dest |
|---|
Source에 들어가는 종류는 3가지가 있습니다. Dest는 두가지로 레지스터 혹은 메모리 주소입니다.
상수를 옯길때
Dest에 직접 상수를 바로 넣는 경우가 있을 수 있습니다. 이때 상수는 아래와 같이 표기합니다.
| movq $0x400, %rax movq $-147, (%rax) |
|---|
상수 앞에는 $를 써서 표기해주면 됩니다. 메모리 주소는 항상 ()안에 넣어줘야 합니다. 이는 레지스터와 구분을 하기 위함입니다. 이를 C의 관점으로 보면 이렇습니다.
| movq $0x400, %rax // temp = 0x400; movq $-147, (%rax) // \*p = -147; |
|---|
레지스터에 있는 값을 옯길때
레지스터에 저장되어 있는 값을 다른 레지스터로 옮길때는 아래 명령어를 사용합니다.
| movq %rax,, %rdx // temp2 = temp1; movq %rax, (%rdx) // \*p = trmp; |
|---|
메모리 값을 옮길때
메모리끼리의 직접 연산은 하지 않기 때문에 Dest에는 항상 register가 들어가야 합니다.
| movq (%rax), %rdx // temp = \*p; |
|---|
다른 비트 버전
movq는 앞서 64비트 데이터를 옮길때 사용되는 명령어라고 하였습니다. 32비트, 16비트에서 사용되는 명령어는 아래와 같습니다.
| movl (Move Longword) // 32bit(4Byte) -> %eax, (%edx) 등을 사용 movw (Move Word) // 16bit (2Byte) -> %ax, (%dx)등을 사용 movb (Move Byte) // 8 bit( 1Byte) |
|---|
\* 해당 분법은 AT&T를 따르고 있으며, intel은 이와 다릅니다.
메모리 주소 지정 방식
메모리에 접근하기 위해서는 보통 메모리의 주소를 가지고 있는 레지스터의 값을 읽어 이동합니다.
하지만, 단순히 메모리 주소를 직접 가지고 있는 레지스터도 있지만, 레지스터의 값과 로직을 이용하여 메모리 주소를 계싼하는 방법도 존재합니다.
Normal
Mem\[Reg(R)\]
이 모드는 레지스터 R이 메모리 주소를 직접 저장하고 있습니다. 즉, 레지스터 R을 읽어들이면 메모리 주소를 알아, 해당 주소로 접근이 가능한 것이죠.
| movq (%rcx), %rax |
|---|
이미 위에서 사용한적이 있습니다. 해석은 %rcx에 저장 된 주소를 읽어(64비트로 된 데잍)들여, 해당 주소로 이동하고 해당 주소의 메모리에 저장된 값을 %rax에 로드하라.
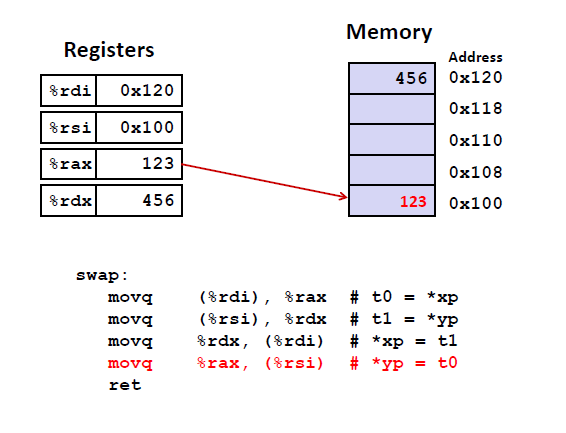
해당 그림을 보시면 직관적으로 이해가 가능합니다.
Displacement
Mem(Reg\[R\] + D)
이 모드는 기본 레지스터 R과 상수 오프셋 D를 결합하여 메모리 주소를 계산합니다. R은 메모리 시작을 지정하고 D는 그 시작점에서의 상대적 위치를 저장합니다.
| movq 8(%rbp), %rax |
|---|
%rbp레지스터에 저장되어 있는 주소값에서 부터 8(바이트!) 떨어진 위치에서 64비트를 읽어와 %rdx로 이동시키라는 명령어입니다. 보통 %rbp는 함수의 프레임 포인터로 사용되고, 8(%rbp)는 스택 프레임 내의 특정 위치를 참조하게 되어있습니다.
Special Case
보다 복잡하게 메모리 주소를 지정할 수 있는 모드가 있습니다. 이는 데이터의 효율적인 저장과, 검색을 돕도록 설계되어, 배열, 구조체 등의 동적 데이터 구조 등을 다룰 때 사용되곤 합니다.
| movq (%rbx, %rcx), %rax |
|---|
이는 %rbx와 %rcx 주소의 합을 주소로 사용하여 참조 후 %rax에 저장하도록 합니다.
| movq 4(%rbx, %rcx), %rax |
|---|
이는 위의 주소에 +4를 한 주소를 참조하여 %rax에 저장합니다.
| movq (%rbx, %rcx, 4), %rax |
|---|
이는 %rcx의 4배를 한 값과 %rbx 를 더하여 주소로 지정하고 값을 참조 후 %rax로 저장합니다.
어셈블리어 산술, 논리 연산
이제 본격적으로 연산에 대해 다뤄봅시다.
leaq
leaq는 Load Effective Address의 줄임말로,주소 계산만 수행하고 실제 메모리에서 데이터를 로드하지 않습니다. 이 명령어는 주로 주소를 계산하거나 복잡한 산술 표현식을 해석할 때 사용합니다.
source: 주소 모드 표현식을 사용합니다. 즉, 메모리 주소를 계산하기 위한 레지스터와 상수의 조합을 나타냅니다. 위에서 공부한 special case를 참고하세요.
Dst: 계산된 주소가 저장할 대상의 위치입니다.
leaq는 데이터를 직접 다루는 것이 아니라, 주소만을 계산하여 저장하는 연산입니다.
| 응용: C언어 포인터 p가 x의 i번째 요소를 가르키고 싶을때 p = &x\[i\]; leaq (%rbx, %rcx, 4), $rax |
|---|
여러 method 총정리
| Format | Computation | result |
|---|---|---|
| addq | Src, Dst | Dst = Dst + Src |
| subq | Src, Dst | Dst = Dst - Src |
| imulq | Src, Dst | Dest = Dest \* Src |
| salq | Src, Dst | Dest = Dest << Src |
| shlq | Src, Dst | Dest = Dest << Src |
| sarq | Src, Dst | Dest = Dest >> Src |
| shrq | Src, Dst | Dest = Dest >> Src |
| xorq | Src, Dst | Dest = Dest ^ Src |
| andq | Src, Dst | Dest = Dest & Src |
| orq | Src, Dst | Dest = Dest | Src |
| inoq | Dst | Dest = Dest + 1 |
| decq | Dst | Dest = Dest - 1 |
| negq | Dst | Dest = -Dest |
| notq | Dest | Dest = ~Dest |
\* salq와 shlq의 차이는 salq는arithmetic의 표기로, 부호있는 정수 시프트에 사용된다. 반면에 shlq는 Logical로 부호에 상관없이 사용된다.sarq와 shrq도 동일하다.