Kafka를 왜 써야하는가
Kafka를 왜 써야하는가 — #개발자의도구들 #kafka #apachekafka #아파치카프카 AI스쿨 msa기반 java 백엔드 코스 중에 공부한 내용...
#개발자의도구들 #kafka #apachekafka #아파치카프카
AI스쿨 msa기반 java 백엔드 코스 중에 공부한 내용을 작성하였습니다
\* 현재 Spring x 프로젝트를 진행하고 있습니다. 전체 목차를 보시려면 여기를 눌러주세요.
\* 해당 프로젝트 이전에 공부한 내용을 보시려면 여기를 눌러주세요.
Kafka 이전의 메세지 전송
카프카는 대규모 메세지 처리를 위한 서버입니다. pub-sub 패턴을 사용하여 구현되었으며, 오픈 소스 입니다. 현재 대부분의 서비스가 메일 서버를 사용할 때 카프카를 이용합니다.
대부분의 회사에서 사용하는 만큼, 카프카를 사용하여 프로젝트를 진행해본 경험이 있다면, 인사 면접에서 빠지지 않고 질문을 한다고 하는데요. 중요한 만큼 기본개념을 확실하게 다지고 가셨으면 좋겠습니다.
현재 notiApi Server 구조를 보면 아래와 같습니다.
// 사진
이는 카프카 이전 부터 사용된 매우 단순한 메세지 전송 구조일 것 입니다. 이런 구조에는 여러가지 문제점이 있었습니다.
                                    메세지를 보내는 서버와 받는 서버가 직접적으로 연결되어 있다.

👉 이런 구조는 다음과 같은 문제를 야기합니다.
- 전달받는 서버가 많아지는 경우 보내는 쪽 서버의 과부화 발생
- 하나의 서버 구조이기 때문에 네트워크 지연이 증가하면 전체 서비스의 성능 저하
- 비동기 처리의 어려움.
이를 해결하기 위해 Pub-Sub 패턴이 개발되었습니다.
Pub-Sub은 모든 문제를 해결하였는가
Pub-Sub 패턴은 메세지 발행 주체를 Publisher로 두고 받는 쪽을 Subscriber로 둡니다. 중간에는 Broker가 있습니다.
이 Publisher와 Subscriber는 서로에 대해서 모르지만, Broker를 통해 메세지를 주고 받습니다. 이때 Broker는 topic단위로 메세지를 관리하게 됩니다.
원초적인 Pub-Sub 패턴으로 구현된 Broker 서버는 publisher의 부담을 완화했습니다. 아무리 연결된 클라이언트가 많아도 broker가 관리를 하다보니 publisher가 부담이 없는 것이죠. 하지만 단일 pub-sub은 여러가지 한계에 직면하게 됩니다.
그중에서도 가장 중요한건 역시나 broker가 떠맡은 많은 부담들입니다. 단일 broker 서버에서 broker가 다운되면 결국 메세지 발행과 소비는 일어나지 않게됩니다. 이런 구조를 해결하려면 여러개의 broker 서버가 논리적인 하나의 구조로 묶여 있어야합니다.
디스크 관점에서 broker를 생각해보면 또 다른 문제가 발생합니다. 단일 broker가 가지고 있는 메세지는 얼마나 보관을 해야할 까요? 수 많은 메세지가 쌓인다면 브로커가 감당할 수 있을까요? 이 역시 단일 pub-sub 구조에서 해결해야할 문제였습니다.
마지막으로 broker는 중재하며, 메세지를 저장하는 것 뿐 아니라 저장된 메세지나 트래픽 관리 등 서버유지 보수를 위한 여러가지 기능들을 요구 받습니다. 이는 사실 어려운 일은 아니지만, 매우 번거로운 일입니다.
이런 단일 pub-sub문제를 해결하기 위한 솔루션으로 Kafka를 사용할 수 있습니다.
Kafka
kafka는 이런 단일 pub-sub 패턴을 해결할 뿐아니라, 메세지니 서버 운영에 대한 여러 기능들을 제공합니다. 덕분에 우리는 직접 복잡한 메세지 서버를 직접 구현하지 않아도 됩니다!
kafka는 하나의 브로커가 아닌 여러개의 브로커로 구성된 클러스터 단위로 동작합니다. 브로커 하나가 다운되어도 다른 브로커를 통해 메세지를 전달받을 수 있습니다. 메세지를 분산하여 저장하기 때문에 물론 디스크 자원이 더욱 필요하겠지만, 훨씬 안전합니다.
kafka의 구조는 아래 그림을 보면서 설명 하겠습니다.
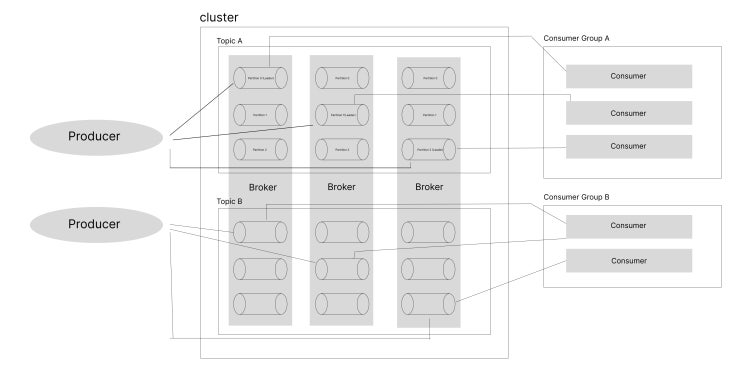
topic A에 대한 메세지를 발행시 한 클러스터 내의 브로커가 해당 토픽에 대해 Replication Factor 만큼 동일 메세지를 여러 브로커의 파티션에 저장합니다. 이때 파티션은 설정할 수 있으며, 하나도 없이 하나의 브로커에만 저장하도록 할 수 있습니다. 파티션은 디스크라고 생각하시면 편합니다.
                                    👉 Topic: 브로커에서 데이터를 관리할 때 기준이되는 개념. 파티션으로 구성된다.
- Replication Factor: 복제 계수, 얼마나 많은 파티션에 복제를 해둘 것인지 결정
- Replication Facotor = 1이라면 오직 하나의 리더 파티션만이 존재
파티션은 Leader와 Follower가 존재합니다. Leader의 경우 Publisher 및 Consumser와 직접 연결된 파티션 입니다. Follower의 경우 예비용 디스크로 보면되는데, 만약 Leader 파티션을 가지고 있는 Broker가 정상작동을 하지 않을 경우 Follower중 하나가 Leader로 승격됩니다.이런 승격 관리를 Controller가 수행합니다.
                                    👉 Controller: 여러개의 브로커 중 하나의 브로커가 Controller를 담당합니다.
클러스터 내부의 브로커 중 하나에 장애가 발생하는 경우, 해당 브로커가 관리하는 파티션 중에
리더 파티션이 존재할 수 있습니다. 이때, 다른 브로커에 존재하는 팔로우 파티션을 리더로 승격합니다.
Consumer는 그룹 단위로 묶여 있으며, 각 컨슈머는 각자의 파티션을 한개 혹은 여러개씩 배정받습니다. 하지만 파티션은 각 하나의 컨슈머에게만 매핑될 수 있습니다. 특정 파티션이 할당된 컨슈머에 장애가 발생되면 해당 파티션은 Coordinator에 의해 다른 컨슈머에게 재할당됩니다.
                                    👉 Coordinator: 클러스터의 여러 브로커 중 하나의 브로커가 Coordinator역할을 맡습니다.
Consumer group의 상태를 체크하여, Consumer 장애 발생으로 Consume이 불가한 경우 해당 파티션을
같은 그룹내의 다른 Consumer에 할당합니다.
Zookeeper -> KRaft
원래 Kafka 서버 환경 분석을 위해 Zookeeper가 사용되었으나, kafka 2.8버전 이상부터는 Zookeeper 없이 사용합니다. Kafka의 KRaft 기능을 사용하면 되는데, 이는 이후 실습하면서 다시 정리하겠습니다.
다음 시간에는 Linux 서버에 직접 kafaka를 설치하고 브로커 연결 및 메세지 발행, Spring과 연결하는 것까지 해보겠습니다.