[java 웹 서버] RDBMS와 정규화 핵심 개념만
[java 웹 서버] RDBMS와 정규화 핵심 개념만 — #RDBMS #DB정규화 #정규화 #데이터베이스 #관계형데이터베이스 #Database #database정규화 #개발자...
#RDBMS #DB정규화 #정규화 #데이터베이스 #관계형데이터베이스 #Database #database정규화 #개발자의도구들
AI스쿨 msa기반 java 백엔드 코스 중에 공부한 내용을 작성하였습니다
\* 현재 웹 서버 프로젝트를 진행중입니다. 전체적인 목차를 보시려면 여기에서 참고하세요
\* 전체코드: https://github.com/keyveloper/HTTP\_server.git
들어가기에 앞서서
이전글을 통해 JDBC를 사용하여 제가 만든 웹서버와 MySQL 서버를 연결하는 과정을 다뤄보았습니다. 제가 사용한 mySQL은 대표적인 RDBMS인데요. 오늘은 RDBMS에 대한 이론적인 부분에 대해 좀 더 깊게 다뤄보고자 합니다.
그나저나 예전에 한번 작성한적이 있었는데, 그때보다 지금 실력이 훨씬 많이 올라가서 뭔가 뿌듯하네요.
> 예전글
RDMBS란?
RDBMS는 Relational DataBase Mangement System의 약자입니다. 이름에서 알 수 있듯이, DBMS의 한 종류이며, 특히 여러 DBMS를 Relational 하게 관리할 수 있는 DBMS가 되겠습니다.
RDBMS에서는 데이터를 tables 형태로 저장하는데, SQL로 원하는 데이터에 접근할 수 있습니다. 현재 많은 시스템에서 사용중인 DBMS이며, 처음 들으시는분도, Excel을 사용해본 경험이 있으시다면 어떤건지 감이 오실거라 생각됩니다.
DBMS와의 차이점?
일반적으로 RDBMS는 DBMS의 한 종류이지만, 구분되는 주요 특징들이 존재합니다.
| RDBMS | DBMS |
|---|---|
| Data stored is in table format | Data stored is in the file format |
| Multiple data elements are accessible together | Individual access of data elements |
| Data in the form of a table are linked together | No connection between data |
| Normalisation is not achievable | There is normalisation |
| Support distributed database | No support for distributed database |
| Data is stored in a large amount | Data stored is a small quantity |
| Here, redundancy of data is reduced with the help of key and indexes in RDBMS | Data redundancy is common |
| RDBMS supports multiple users | DBMS supports a single user |
| It features multiple layers of security while handling data | There is only low security while handling data |
| The software and hardware requirements are higher | The software and hardware requirements are low |
| Oracle, SQL Server. | XML, Microsoft Access. |
정리가 잘되어있는 표가 있어서 가져왔습니다. 주요특징을 간략하게 보자면 RDBMS는 보다 많은 사용자가 동시에 사용할 수 있고, 대용량 처리가 가능합니다. 또한, 데이터를 서로 연관시켜 묶어서 관리합니다. 더 복잡한 시스템이며, 용량도 크기 때문에 그에 따라 더 발전된 소프트웨어 및 대용량의 하드웨어가 요구됩니다.
ACID
RDBMS하면 무조건 나오는 keyword가 있습니다. 그건 바로 ACID인데요. RDBMS의 주요 특징 4가지의 앞글자만 따서 ACID로 부르고 있습니다.
- Atomacity: Transaction이 데이터베이스에 모두 반영되거나, 모두 반영되지 않아야 한다는 원칙입니다.
- Consistency: 사전적 정의로는 "harmonious connection, as of the parts of a system", "steady adherence to principles, patterns of action, etc."으로, 시스템 내에서 데이터들이 원칙에 따라 무결하게 유지되어야 함을 의미하고 있습니다.
- Isolation: 다중 Client에 의해서 (RDMBS는 multiple User를 지원함) Database가 동시에 조작될 가능성이 있습니다. 이때 각 User의 조작 단위를 Transaction으로 보는데, 이 Transaction이 서로에게 간섭없이 각각 독립적으로 수행되어야 한다는 원칙입니다.
- Durability: "power of lasting or continuing in the same state, resistance to decay or dissolution," Transaction이 성공적으로 반영된 이후, 반영된 데이터나 수정된 데이터베이스의 상태는 계속해서 유지되어야 한다는 의미입니다.
이 원칙은 정보처리기사뿐만 아니라, 학교시험에서도 자주 출제되는 부분이라 꼭 기억하시면 좋을 것 같습니다!
관련용어
기본적으로 RDBMS애서 사용하는 용어들을 기억해둘 필요가 있습니다. (시험에 자주 나와요)
릴레이션, 스키마, 도메인, 어트리 뷰트,
Key
앞서 RDBMS는 테이블 형태로 저장되며, 서로 연관된 table끼리 관련성을 만들 수 있다고 했는데요. 이때 사용하는게 바로 key입니다.
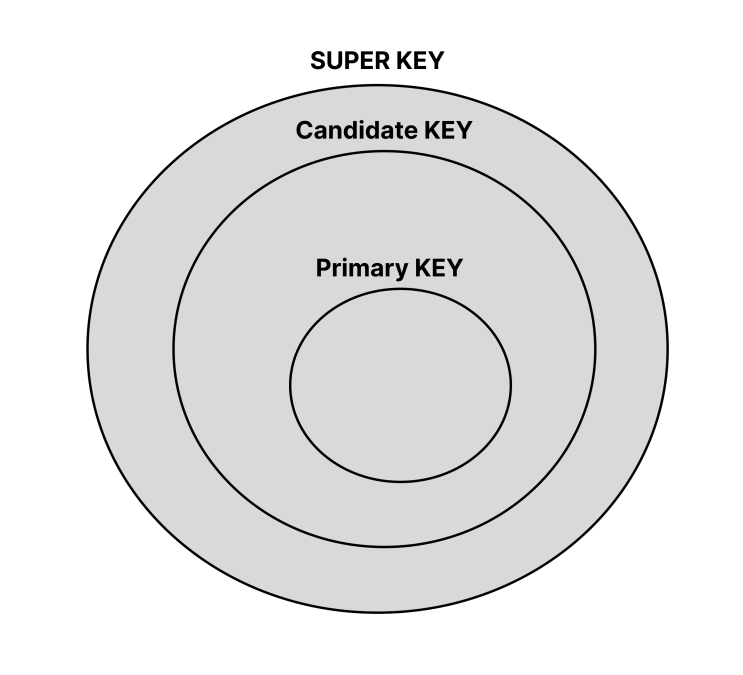
key는 Super key, Cadidate key, Primary Key로 구분이 되는데, 범위가 점점 좁혀져가는 개념입니다. key를 배우는 목적은 결국에는 Primary Key를 찾기 위함입니다.
| STUD\_NO | STUD\_NAME | STUD\_PHONE | STUD\_LOCATION |
|---|---|---|---|
| 1 | min | 055-111-1234 | MASAN |
| 2 | yang | 02-123-5678 | SEOUL |
| 3 | shu | 052-111-1234 | ULSAN |
| 4 | may | 033-111-1234 | GANGWON |
- Super Key
슈퍼키는 하나의 튜플(행)을 구분(유일성)할 수 있는 속성들의 집합입니다. 위 테이블에서 예를 들어보면, STUD\_NO으로 유일하게 식별이 가능함을 알 수 있습니다. STUD\_NAME은 동명이인, STUD\_LOCATION은 같은지역, STUD\_PHONE은 같은 집 전화를 쓰는 학생이 추가될 수 있기에 유일성을 만족하지 못합니다.
하나의 속성만을 키로 보지 않고 STUD\_NO, STUD\_NAME이렇게 두개의 속성을 묶어서 superkey로 구분할 수도 있습니다. (STUD\_NO, STUD\_NAME), (STUD\_NO, STUD\_PHONE), (STUD\_NAME, STUD\_PHONE) 등 등이 가능합니다.
- Candidate Key
Super key의 여러 후보중에 최소한의 속성들로 튜플들을 구분할 수 있는 키를 Candidate Key라고 부릅니다. 즉, Super key의 후보중에, 최소한의 속성을 사용하여 구분이 튜플 구분이 가능한 key라는 의미입니다.
위에서는 STUD\_NO이 되겠습니다. STUD\_NO 말고는 모두 두개 이상의 속성들로 구성된 Super key이기 때문입니다.
Candidate Key는 유일성(Unique)과 최소성(minimal)을 모두 만족해야 하는 슈퍼키인 것 입니다.
- Primary Key(기본 키)
이제 핵심인 Primary Key를 알아봅시다. 모든 테이블에는 Candidate key가 존재할 수 밖에 없습니다. 이중에서 반드시 하나의 기본키가 존재해야하며, 반드시 모든 열에 대해 고유하게 식별이 가능(개체 무결성)해야합니다. 이런 이유로 Primary Key는 다른 키들과 달리 Null이 될 수 없습니다.
| STUD\_NO | STUD\_NAME | STUD\_PHONE | STUD\_LOCATION |
|---|---|---|---|
| 1 | min | 055-111-1234 | MASAN |
| 2 | yang | 02-123-5678 | SEOUL |
| 3 | shu | 052-111-1234 | ULSAN |
| 4 | may | 033-111-1234 | GANGWON |
| 5 | mumu | 053-111-1111 | ULSAN |
| 6 | ship | 02-123-5678 | SEOUL |
이 테이블의 후보키에서 STUD\_NO로 모든 row를 고유하게 식별이 가능하며, 절대 NULL을 가질 수 없는 구조입니다.
번외) Foreign Key (외래 키):
외래 키는 다른 테이블의 기본 키를 참조하여 테이블 간의 관계를 설정합니다. 보통 하나의 테이블의 기본키를 다른 테이블의 외래키로 설정하여 참조하게 되는데 참조되는 쪽을 부모 테이블, 참조하는 쪽을 자식 테이블로 부르기도 합니다.
참조 무결성의 원칙에 따라 참조되는 부모테이블의 기본키는 자식 테이블의 참조키가 존재하는한 변경되거나, 삭제될 수 없습니다. 만약 수정 및 삭제를 하고 싶다면, 자식 테이블의 참조키도 함께 수정, 삭제되도록 설정해야합니다.
| STUD\_NO | STUD\_NAME | STUD\_PHONE | STUD\_LOCATION |
|---|---|---|---|
| 1 | min | 055-111-1234 | MASAN |
| 2 | yang | 02-123-5678 | SEOUL |
| 3 | shu | 052-111-1234 | ULSAN |
| 4 | may | 033-111-1234 | GANGWON |
| 5 | mumu | 053-111-1111 | ULSAN |
| 6 | ship | 02-123-5678 | SEOUL |
위 테이블에 담당 선생님에 대한 정보를 넣고자 한다면, TEACHER테이블을 만들어 TEACHER테이블의 기본키를 외래키로 참조하여 만들 수 있습니다.
| TEACHER\_NO | TEACHER\_NAME | TEACHER\_SUBJECT |
|---|---|---|
| 1 | SAM | MATH |
| 2 | SUNG | COMPUTER |
| 3 | ELL | ENGLISH |
| 4 | GGY | FRANCH |
| 5 | Uclass | ARITHMETIC |
| 6 | artina | PHYSICS |
| STUD\_NO | STUD\_NAME | STUD\_PHONE | STUD\_LOCATION | (TEACHER\_NO) |
|---|---|---|---|---|
| 1 | min | 055-111-1234 | MASAN | 1 |
| 2 | yang | 02-123-5678 | SEOUL | 1 |
| 3 | shu | 052-111-1234 | ULSAN | 2 |
| 4 | may | 033-111-1234 | GANGWON | 3 |
| 5 | mumu | 053-111-1111 | ULSAN | NULL |
| 6 | ship | 02-123-5678 | SEOUL | 4 |
정규화란?
데이터베이스 정규화란 데이터를 어떻게 organizing할 것인가에 대한 과정이라고 생각하시면 됩니다. 테이블을 생성하는 과정과, 테이블들의 관계를 만드는데 따라야할 행동 지침이라고 보시면 좋을 것 같습니다.
정규화를 하는 이유는 여러가지가 있겠지만, 가장 큰 이유는 중복을 제거 하는 것입니다. 하나만 저장되면 되는 데이터가 여러군데 존재하게 되면, 디스크 용량을 잡아먹을 뿐 아니라, 사용자에게 혼란을 야기할 수도 있습니다.
정규화는 여러 단계가 존재하는데 총 5(+0.5)단계로 보시면 됩니다. 1단계를 만족하는 데이터베이스는 "1정규형을 만족한다"고 표현합니다.
정규화에 대한 구체적이고 공식적인 룰이 존재하지만, 현실에서는 항상 이 룰들이 만족되는건 아닙니다. 때에 따라서 정규화를 하지 않는 것이 유리하게 작용될 때도 존재하기 때문입니다. 오늘은 일단 formal한 정규형 관정을 세부적으로 다루는데 초점을 두겠습니다.
First Normal Form
제 1정규형
제 1정규형을 만족하려면, 다음 조건을 만족시켜야합니다.
- 다중 속성 제거
만약 한 속성에 다중값이 존재한다면, 제거하고 단일 속성으로 만들어야합니다.
| STUD\_NO | STUD\_NAME | STUD\_PHONE | STUD\_LOCATION |
|---|---|---|---|
| 1 | min | 055-111-1234010-1234-5678 | MASAN |
| 2 | yang | 02-123-5678 | SEOUL |
| 3 | shu | 052-111-1234 | ULSAN |
| 4 | may | 033-111-1234 | GANGWON |
위의 1번 학생의 STUD\_PHONE에 속성값이 2개 이상 존재하기 때문에 이를 나눠 주면 됩니다.
| STUD\_NO | STUD\_NAME | STUD\_PHONE | STUD\_LOCATION |
|---|---|---|---|
| 1 | min | 055-111-1234 | MASAN |
| 1 | min | 010-1234-5678 | MASAN |
| 2 | yang | 02-123-5678 | SEOUL |
| 3 | shu | 052-111-1234 | ULSAN |
| 4 | may | 033-111-1234 | GANGWON |
그럼 이제 제 1정규형을 만족한 데이터베이스가 되었습니다. 만족은 하지만, 여전히 불필요하게 중복되어 있는 부분이 있기 때문에, 다음 정규형으로 넘어가야 합니다.
Second Normal Form
제 2정규형
참고로 모든 제 n정규형은 n보다 작은 정규형을 모두 만족시킵니다. 그럼 제 2정규형은 제 1정규형읆 만족한 상태에서 시작합니다.
2nf의 핵심은 부분적 함수 종속을 제거하는 것 입니다. 보통 키 x가 속성 y를 결정하는 경우 y는 X에 함수적 종속되어있다고 표현합니다. 기호로는 X -> Y로 표기합니다. 아래 예시를 보겠습니다.
| STUD\_NO | COURSE\_NO | COURSE\_FEE |
|---|---|---|
| 1 | C1 | 1000 |
| 1 | C2 | 1500 |
| 1 | C3 | 2000 |
| 3 | C2 | 1500 |
| 4 | C4 | 4000 |
이 테이블의 후보키는 뭔지 생각해 봅시다.
- STUD\_NO -> COURSE\_NO? X (연관 없는 속성)
- STUD\_NO -> COURES\_FEE? X (연관 없는 속성)
- COURSE\_NO -> COURSE\_FEE? O (COURSE\_NO을 알면 COURSE\_FEE를 알 수 있다)
- COURSE\_NO -> STUD\_NO ? X (연관 없는 속성)
- COURSE\_FEE -> COURSE\_NO? X (같은 가격의 COURSE가 존재가능하다)
- COURSE\_FEE -> STUD\_NO? X (연관 없는 속성)
- (STUD\_NO, COURSE\_NO) -> COURSE\_FEE? O (굳이 따지자면 가능)
- (COUSE\_NO, COURSE\_FEE) -> STUD\_NO ? X (연관이 전혀 없다)
위의 테이블에서 식별이 가능한 후보키는 바로 7번인 (STUD\_NO, COURSE\_NO) 입니다. 후보키가 하나 밖에 없으니 그 후보키가 바로 기본키가 되겠네요. 이때 기본키의 속성을 prime-attribute라고 하며, 기본키가 아닌 속성은 non-prime attribute라고 부릅니다.
하지만, 이 속성은 완벽하게 부분적 함수 종속을 만족하고 있습니다. 부분적 함수 종속은 (A, B) -> C에서, A -> C혹은 B ->C를 만족하는 경우를 말합니다. 이때 C는 non-prime attribute입니다.
기본키를 다시보면, (STUD\_NO, COURSE\_NO) -> COURSE\_FEE 입니다. 이때 COURSE\_NO -> COURSE\_FEE(non-prime)를 결정하기 때문에 부분적 함수 종속이 되겠습니다.
이를 제거 하기 위해서는 테이블을 따로 만들어 관리해주면 됩니다.
| STUD\_NO | COURSE\_NO |
|---|---|
| 1 | C1 |
| 1 | C2 |
| 1 | C3 |
| 3 | C2 |
| 4 | C4 |
| COURSE\_NO | COURSE\_FEE |
|---|---|
| C1 | 1000 |
| C2 | 1500 |
| C3 | 2000 |
| C2 | 1500 |
| C4 | 4000 |
여기서 정규화의 핵심이 나오는데, 정규화를 진행함으로서, 테이블이 계속해서 늘어나는 현상이 발생한다는 것입니다.
Third Normal Form
제 3정규형
제 3정규형의 정의는 non-prime attribute에 대해 이행적(transitive) 함수 종속이 존재하지 않는 상태를 의미합니다.
이행적 함수 종석은 기호로 이렇게 표현됩니다. A -> B, B -> C 예시를 통해 보겠습니다.
| STUD\_NO | STUD\_NAME | STUD\_STATE | STUD\_CONTURY |
|---|---|---|---|
| 1 | MINSU | SEOUL | KOREA |
| 2 | JUNGHOON | GANGWON | KOREA |
| 3 | JOA | GANGWON | KOREA |
현재 위 테이블의 기본키는 STUD\_NO입니다. 이때, STUD\_NO이 STUD\_STATE를 결정합니다. 하지만 STUD\_STATE역시 STUD\_CONTURY를 결정할 수 있습니다. STUD\_NO -> STUD\_STATE, STUD\_STATE -> STUD\_CONTURY 형태가 되어 transitive 함수 종속 관계가 성립됩니다.
역시나 이를 제거하는 방법은 테이블을 나누는 것 입니다. 아니면, 불필요한 속성 자체를 삭제하는 것도 방법이 될 수 있습니다.
BCNF
BCNF는 Boyce-Codde Normal Form의 약어로, 제 3정규형을 좀 더 확장한 개념입니다. 혹자는 3.5 정규형이라고도 부르기도 하는데, 기본적으로 제 3정규형을 만족해야 합니다.
조건은 모든 결정자가 후보키 집합에 속해야 한다 입니다.
| STUD\_NO | STUD\_SUBJECT | STUD\_TEACHER |
|---|---|---|
| 1 | MATH | JIN |
| 2 | C+ | POO |
| 3 | JAVA | SUN |
해당 테이블을 보면, 후보키로 (STUD\_NO, STUD\_SUBJECT)가 될 수 있겠습니다. 이때, non-prime인 STUD\_TEACHER이 STUD\_SUBJECT를 결정할 수 있는데, 이는 STUD\_SUBJECT 자체가 후보키에 속하지 않기 때문입니다.
Fourth Normal Form
제 4정규형
제 4정규형은 BCNF정규형을 만족하는 테이블에서, 다치 종속을 제거한 형태입니다.
| STUD\_NO | STUD\_SUBJECT | STUD\_STATEMENT |
|---|---|---|
| 1 | MATH | SEOUL |
| 1 | PYTHON | SEOUL |
| 2 | C+ | BUSAN |
| 3 | JAVA | MASAN |
위 테이블에서의 STUD\_NO는 STUD\_SUBJECT의 여러개의 값을 가지고 있습니다(다치종속). 또한 최소한의 칼럼 3개를 만족하며 A와 B사이의 다치 종속성이 존재하는 경우와 B와 C가 독립적이기도 합니다.
Fifth Normal Form (PJNF)
제 5정규형
제 5정규형은 분해할 수 있는 만큼 전부 분해하는 정규형입니다. 다른말로는 Project Join Normal Form으로 불립니다.
제 4규형을 만족하는 테이블에서, 조인 종속을 제거하여 조인 연산시 손실을 없앱니다.
REF
https://learn.microsoft.com/en-us/office/troubleshoot/access/database-normalization-description
https://www.geeksforgeeks.org/normal-forms-in-dbms/