Elastic Search 깊게 보기
Elastic Search 깊게 보기 — #개발자의도구들 #ElasticSearch #ELK AI스쿨 msa기반 java 백엔드 코스 중에 공부한 내용을 작성하...
#개발자의도구들 #ElasticSearch #ELK
AI스쿨 msa기반 java 백엔드 코스 중에 공부한 내용을 작성하였습니다
\* 현재 Spring x 프로젝트를 진행하고 있습니다. 전체 목차를 보시려면 여기를 눌러주세요.
\* Devops stack: 여기
\* 리눅스 기본기: 여기
Elastic Search에 대해
이전글을 통해 Elastic Search는 여러 서버에서 발생한 로그를 모으는 Database 역할이라고 하였습니다.
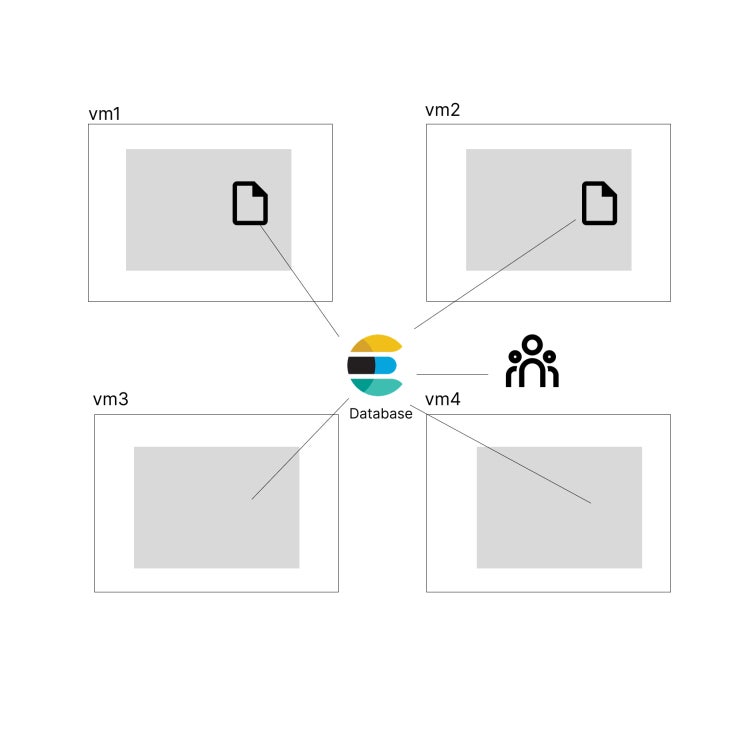
elastic search는 RDBMS와는 다르게 동작합니다. 또한 저만의 쿼리문을 가지고 있습니다. 기본적으로 RESTful API를 지원하기 때문에 HTTP 통신에 익숙하다면 적응하는데 큰 어려움이 없습니다.
👉 로그를 위한 DBMS이기 때문에 데이터 저장, 조회 등의 근본적인 역할은 똑같다.
오늘은 Elastic search의 뼈대가 되는 내부 구조와 역 인덱싱에 대해 다뤄보겠습니다.
클러스터 구성
🏠 Cluster
Kafka를 제대로 공부하셨다면 Cluster가 뭔지 아실겁니다. Cluster는 노드들의 집합입니다. 노드는 물리적 컴퓨터나 혹은 가상 머신을 의미합니다.
ELK에서는 서로 다른 노드들을 묶어(물리적으로 다르게 분리되었다는 의미) 클러스터를 구축할 수 있습니다. 사실 이는 Kafka나 이후 등장할 K8S에도 동일하게 적용됩니다.
📞 Cluster Communication
클러스터 내부에 속한 노드들은 서로 통신이 가능합니다. 뿐만아니라 Node는 일반 클라이언트(외부)와도 통신해야하기 때문에 이를 위한 포트를 따로 지정하고 있습니다.
클라이언트와의 통신은 9200/tcp, 클러스터 내부 노드간의 통신은 9300/tcp로 이루어집니다.
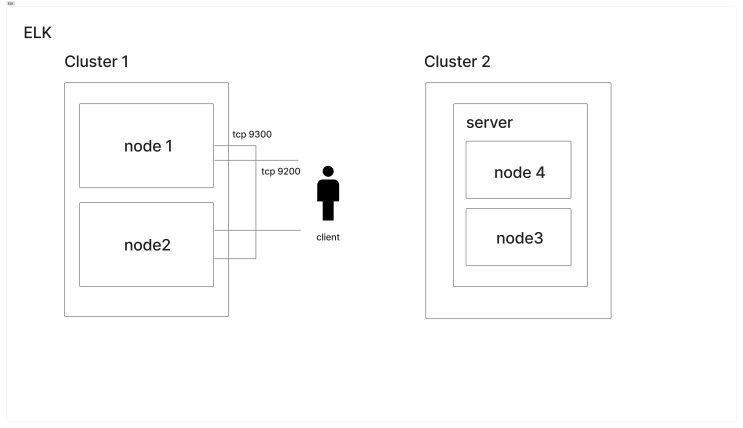
보통은 하나의 VM(혹은 물리적 서버) 내에 하나의 node를 실행시키는 것을 권장하고 있습니다. 하지만, cluster 2의 서버 처럼 하나의 서버 내에 다수의 노드를 동작시키는 것 역시 가능합니다.
이렇게 하나의 서버당 하나의 노드를 사용하도록 권장하는 이유는 아래와 같은 저장 방식 때문입니다.
저장 방식
📦 Document
Atomic, adress-able unit of data that you index and search.
- *인덱스화 하여 검색할 수 있는 최소 데이터 단위 입니다.
RDBMS는 Query 문을 사용하여 CRUD 작업을 합니다. 하지만 Elastic search는 RestfulApi를 사용하여 CRUD 작업을 진행합니다.
                                    PUT /my-index/_doc

{
  "user": "jinyoung",
  "age": 27,
  "skills": ["kotlin", "spring"],
  "address": { "city": "Seoul", "zip": "06236" }
}
이렇게 method와 uri를 명시하고 HTTP 프로토콜 body에 원하는 Json 데이터를 넣어주면됩니다.
                                    🤔 my-index?
 my-index는 테이블 개념으로 어떤 index에 json 데이터를 저장할 것인지 명시한다.

PUT /my-index                 # creates the empty index first
{
  "settings": { "index.number_of_shards": 3 }
}

이렇게 직접 index를 생성할 수 있다.
혹은 처음 put요청을 보냈다면 Elastic search가 자동으로 생성해준다.
                                    🤔 _doc?
 ES 7 버전 이상부터는 document 타입 개념이 사라졌다. 대신 _doc을 사용한다.
모든 URL에 _doc을 포함하도록 명시하고 있다.
- method /{index}/\_doc *: 이 패턴으로 CRUD 작업을 합니다.
추가적으로 PUT의 응답에서 부터 해당 {idex}(table 개념)에서 내가 보낸 json 데이터가 어떤 identifier로 조회가 가능한지 받아볼 수 있습니다.
                                    {
  "_index": "my-index",
  "_id":    "D5wwYIcBgfj2KRMZV1IT",
  "result": "created"
}
- *\_id로 나의 json 데이터를 직접적으로 조회할 수 있습니다. table의 primary key와 같은 개념입니다.
🧩 Shard
ELK는 고가용성(High Availability)을 운용하기 위해 Shard를 사용합니다. shard는 Table의 partition이라고 이해하면 가장 직관적입니다.
만약 사용자가 3개의 데이터(\_id: 1, 2, 3)을 동일 인덱스(my-idex)에 보냈다고 가정해봅시다. 이때 \_id를 hash하여 shard 번호를 결정합니다. 모두 다른 hash 값으로 인해 3개의 shard로 분산되어 저장될 수 있습니다.
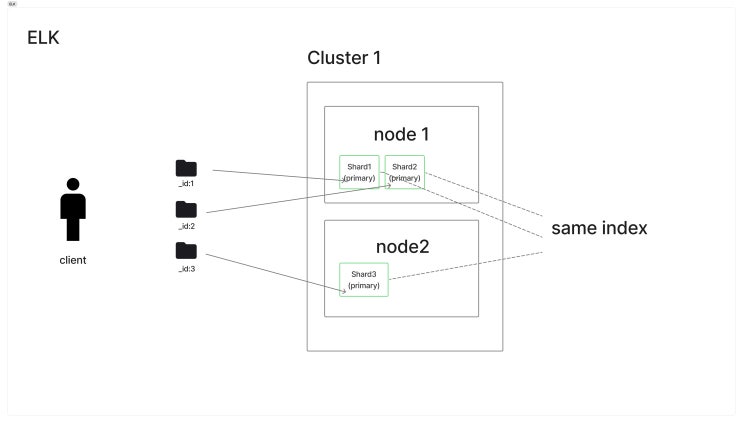
이때 shard는 독립적인 공간으로 물리적으로 분리되어있습니다. 즉 \_id1을 shard 2에서 절대 찾을 수 없습니다.
실제 검색단계에서는 ES는 index를 참고하여 모든 shard를 참고하여 데이터를 가져옵니다. 만약에 shard3 혹은 node2 자체가 다운된다면 shard 3에 저장된 데이터를 볼 수 없게됩니다.
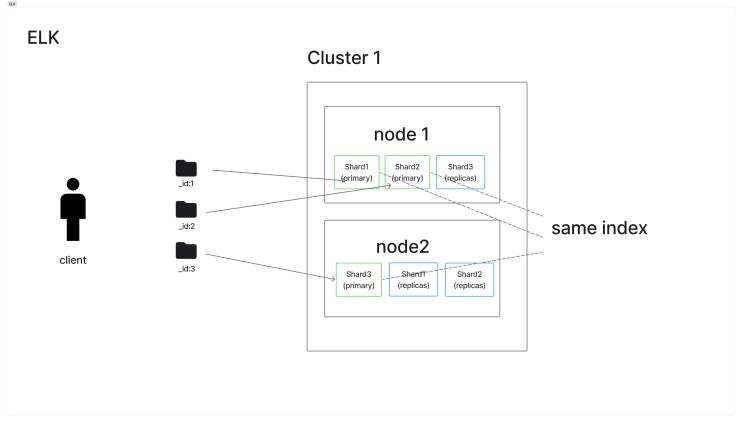
이를 해결하기 위해 replicas를 설정해 둘 수 있습니다. replicas는 shard의 복제본으로 읽기 전용 shard입니다. 각 노드에 서로의 shard를 복제 해두면 node3가 다운되어도 ES는 여전히 shard 3의 데이터를 읽어들일 수 있습니다.
👉 Elastic Search는 고가용성을 위해서 최소 3개의 Node에서 서비스를 운용할 것을 권고하고 잇습니다.
처음 생성된 shard를 primary라고 부르며, 이후 복제된 shard를 replicas라고 부릅니다. primary shard가 망가지면 데이터의 수정 입력이 불가하기 때문에, replicas에서 새로운 primary를 선출하게 됩니다.
Reference
[Reading and writing documents | Elasticsearch Guide \[8.18\] | Elastic
Introduction edit Each index in Elasticsearch is divided into shards and each shard can have multiple copies. These copies are known as a replication group and must be kept in sync when documents are added or removed. If we fail to do so, reading from one copy will result in very different results t...
www.elastic.co](https://www.elastic.co/guide/en/elasticsearch/reference/8.18/docs-replication.html)
[Introduction to Apache Lucene
Apache Lucene™ is a high-performance, full-featured text search engine library written entirely in Java. It is a technology suitable for…
medium.com](https://medium.com/@karkum/introduction-to-apache-lucene-7d65f67f5231)
https://esbook.kimjmin.net/03-cluster
[3. Elasticsearch 시스템 구조 | Elastic 가이드북
이 문서의 허가되지 않은 무단 복제나 배포 및 출판을 금지합니다. 본 문서의 내용 및 도표 등을 인용하고자 하는 경우 출처를 명시하고 김종민(kimjmin@gmail.com)에게 사용 내용을 알려주시기 바랍니다.
esbook.kimjmin.net](https://esbook.kimjmin.net/03-cluster)
- 특히나 이 블로그에서 많은 도움을 얻었음